Den beste KI-assistenten er den du slipper å forklare alt til
Aage Thorsen
CTO
Hvis du må forklare en KI-assistent hvilket selskap du jobber med, hvilket budsjett du ser på og hvilken linje du ønsker analysert, har noen allerede gjort en dårlig jobb med integrasjonen.
Vi har blitt vant til at kunstig intelligens begynner med et tomt tekstfelt. Vi skriver et spørsmål, legger til bakgrunnsinformasjon, laster kanskje opp et dokument og forsøker å formulere oss så presist som mulig, og får vi et dårlig svar, prøver vi igjen med en bedre prompt. Det fungerer godt til mange oppgaver, men jeg mener det er et dårlig utgangspunkt når KI skal integreres i profesjonelle fagsystemer.
Hvis jeg sitter og arbeider med et budsjett, vet applikasjonen hvilket selskap jeg er inne på, hvilken periode jeg ser på, hvilke tall jeg arbeider med og hvilken del av budsjettet som har oppmerksomheten min. Å be meg gjenta det i et tekstfelt er ikke intelligent samhandling. Det er et tegn på at for mye av integrasjonsarbeidet er lagt over på mennesket.
Kontekst er ikke en prompt. Det er arkitektur.
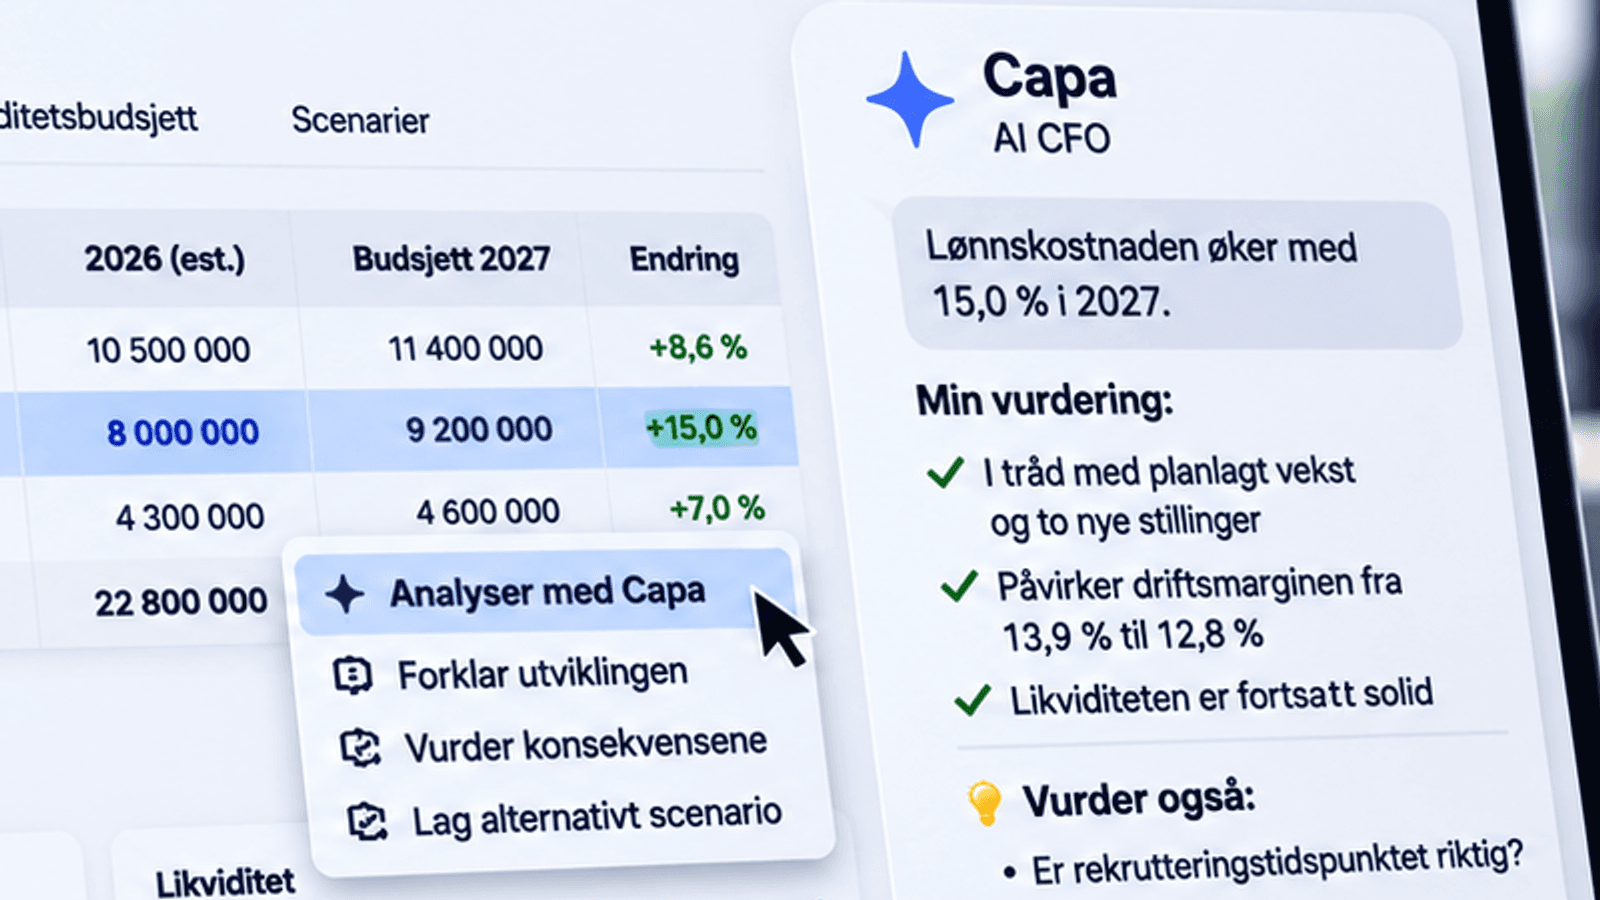
La oss bruke budsjettering som eksempel. En bedriftsleder arbeider med resultatbudsjettet for 2027 og vurderer å øke lønnskostnadene med 15 prosent. Det kan skyldes planlagte ansettelser, lønnsjusteringer eller en kombinasjon, og spørsmålet er om økningen er fornuftig sett opp mot selskapets forventede utvikling. En generell KI-tjeneste kan bidra med interessante betraktninger, men først må den få vite hva selskapet driver med, hvor mange ansatte det har, hva dagens lønnskostnader er og hva som ligger til grunn for vekstforventningene. I et økonomisystem er mye av dette allerede kjent. Utfordringen er derfor ikke å få brukeren til å formulere et bedre spørsmål, men å sørge for at systemet gir KI-en riktig grunnlag for å besvare det.
I Capassa har vi valgt å gjøre samhandlingen så enkel som mulig: Du høyreklikker på en budsjettlinje og ber Capa analysere tallet. Det interessante er ikke høyreklikket, men det som skjer mellom handlingen og svaret. Applikasjonen identifiserer hva brukeren faktisk ber om, hvilke data som er relevante og hvordan de skal presenteres for modellen. Den skiller mellom en enkeltpost og en sum og vet hvordan summen er bygget opp av kontogrupper, den forstår perioden som analyseres, og den behandler ikke en månedskostnad som en årskostnad. Arbeider brukeren med et scenario, tar analysen utgangspunkt i det scenarioet og blandes ikke med et annet budsjett. Slike detaljer kan virke trivielle, men det er her økonomiske analyser enten blir nyttige eller misvisende, og de løses gjennom programvarearkitektur, ikke ved å håpe at en språkmodell gjetter seg frem til sammenhengen.
Det er også derfor jeg mener det ikke er nok å legge KI som et samtalegrensesnitt oppå eksisterende programvare, uten at kontekst og beregninger er tatt stilling til. En chat kan være et fint supplement, men hvis den er eneste inngang og brukeren fortsatt må finne informasjonen og forklare sammenhengene, har vi ikke kommet særlig langt. Det er forskjell på datatilgang og arbeidskontekst: En agent kan ha tilgang til enorme mengder informasjon uten å forstå hva brukeren forsøker å oppnå.
Mer informasjon er ikke det samme som bedre innsikt
En vanlig misforståelse er at modellen blir bedre jo mer vi gir den. Har et selskap titusenvis av transaksjoner og spørsmålet gjelder lønnskostnadene, er det sjelden fornuftig å sende alle til en språkmodell og be den finne ut hva som er relevant. Det gir større datamengder, høyere kostnader og mer å sortere, og enda viktigere: Vi overlater til en probabilistisk modell oppgaver som vanlige programvarekomponenter løser mer presist. En språkmodell bør ikke brukes som en dyr kalkulator. Går lønnskostnadene fra åtte til 9,2 millioner kroner, trenger vi ikke KI for å regne ut at det er 15 prosent. Sammenligning av budsjett og regnskap, marginer og summer av kontogrupper bør gjøres med vanlige, etterprøvbare beregninger. Jeg har skrevet mer om dette i KI kan gi et perfekt svar. På feil tall.
Språkmodellens styrke er å tolke resultatene, identifisere det som fortjener oppmerksomhet og hjelpe brukeren å forstå hvilke spørsmål som bør stilles videre. En økning i lønnskostnadene kan være helt fornuftig hvis den understøtter en realistisk vekstplan, og et faresignal hvis inntektene ikke forventes å øke tilsvarende. For å vurdere det må modellen få kvalitetssikrede tall og nok informasjon om sammenhengen de inngår i. Programvaren skal håndtere data, tilgangskontroll, definisjoner og beregninger. KI-en skal bruke dette grunnlaget til å analysere, forklare og utfordre.
La programvaren regne. La KI-en resonnere.
KI må også vite hva den ikke skal få tilgang til
Når vi snakker om kontekstbevisste agenter, er det lett å fokusere på hvor mye informasjon de bør få. Minst like viktig er hva de ikke skal ha. En bruker som arbeider med ett selskap, skal ikke kunne få tilgang til data fra et annet. En analyse av et budsjett krever ikke innsyn i hvert underliggende bilag. Og skal en agent forklare et nøkkeltall, må definisjonen og beregningsgrunnlaget være kjent, slik at resultatet kan etterprøves. Dette kan ikke løses med en instruksjon om at språkmodellen skal være forsiktig. Tilgangskontroll, dataseleksjon og validering må håndheves av systemene rundt modellen, og KI-en skal verken avgjøre hva brukeren har lov til å se eller kontrollere sine egne beregninger uten et uavhengig grunnlag. OWASPs topp ti for agentiske applikasjoner tar for seg nettopp slike risikoer, blant annet misbruk av verktøy og for vide tilganger.
I økonomisystemer er dette spesielt viktig fordi feil kan få store konsekvenser. Et svar som høres rimelig ut, kan påvirke beslutninger om investeringer, bemanning og finansiering, og da holder det ikke at modellen vanligvis treffer godt. Vi må kunne forstå hvor tallene kommer fra, hva analysen bygger på og hvor grensene for konklusjonen går.
Den beste teknologien er den som kommer ut av veien
Jeg tror vi kommer til å se et tydelig skille mellom to typer KI-løsninger. På den ene siden får vi programvare som har fått et KI-felt der brukeren kan stille spørsmål, og på den andre systemer der KI er integrert i selve arbeidsprosessen og gir relevant hjelp når behovet oppstår. Det første er enkelt å demonstrere. Det andre er vanskeligere å bygge, fordi det krever at vi forstår både fagområdet, datamodellen og arbeidsoppgavene brukeren faktisk utfører.
For en bedriftsleder som lager neste års budsjett, er ikke målet å føre en samtale med en språkmodell, men å forstå om virksomheten har råd til å ansette flere, om vekstforutsetningene er realistiske og hva som skjer med likviditeten hvis planene ikke utvikler seg som forventet. For en CFO handler det om et bedre beslutningsgrunnlag med mindre manuelt arbeid, og for en regnskapsfører om mer tid til å hjelpe kundene med de økonomiske valgene de står overfor. Vi snakker mye om hvor intelligente KI-modellene har blitt. Jeg tror vi bør bruke minst like mye tid på å diskutere hvor intelligent vi bygger programvaren rundt dem.
Den beste KI-assistenten er ikke den du kan spørre om alt. Det er den som forstår hva du arbeider med, og kan hjelpe deg uten at du må forklare alt først.
Flere innlegg
Fra bakspeil til frontrute: Hva en AI-first CFO trenger
BCG skriver at økonomiavdelinger bruker omtrent 90 prosent av tiden på å produsere tall og 10 prosent på å rådgi. I regnskapsbransjen kommer 91 prosent av omsetningen fra produksjon og 4,7 prosent fra rådgivning. Det er to ulike målinger, men de peker samme vei: for mye bakspeil og for lite frontrute.
MCP er rørleggerarbeid, ikke intelligens
Juli-revisjonen av MCP fjernet mye av det som gjorde protokollen krevende å drifte. Men MCP gjør ikke en agent smartere. Aage Thorsen forklarer hva som ble løst, hva som står igjen, og hvorfor MCP er riktig som ytre grense, men sjelden for den indre kjernen i en agent du selv kontrollerer.
Få nye analyser i innboksen
Ett nytt innlegg i uken, aldri mer. Ingen produktreklame.
Nysgjerrig på hvordan Capassa fungerer i praksis?
Ta kontakt